Gần như cuộc trao đổi nào về AI với khách hàng doanh nghiệp, sớm hay muộn cũng đi tới cùng một câu hỏi: "Dữ liệu của chúng tôi có đi ra ngoài không?"
Đó là câu hỏi đúng. Nhưng câu trả lời ít khi gói gọn trong "cloud" hay "local". Giữa hai đầu đó có nhiều lựa chọn khác nhau, và mỗi lựa chọn đổi lấy một thứ: chất lượng mô hình, chi phí, tốc độ triển khai hoặc mức độ kiểm soát.
Bài viết này so sánh bốn hướng triển khai AI phổ biến hiện nay, những điểm hay bị hiểu sai về từng hướng, và một cách đơn giản để doanh nghiệp tự xác định mình nên bắt đầu từ đâu.
Rủi ro lớn nhất thường không nằm ở hạ tầng
Trước khi so sánh kiến trúc, có một điểm cần nói rõ.
Ở nhiều doanh nghiệp, rủi ro dữ liệu lớn nhất hiện nay không đến từ một hệ thống AI được thiết kế kém. Nó đến từ việc nhân viên tự dùng tài khoản ChatGPT, Gemini hay Claude cá nhân, rồi dán hợp đồng, mã nguồn hoặc bảng lương vào để "nhờ AI xử lý cho nhanh". Hiện tượng này thường được gọi là shadow AI.
Năm 2023, Samsung đã phải hạn chế nhân viên dùng công cụ AI tạo sinh sau khi một số kỹ sư đưa mã nguồn nội bộ vào chatbot. Trường hợp như vậy không hiếm, chỉ là ít khi được công bố.
Vì vậy, câu hỏi đầu tiên không phải là "nên chọn cloud hay local", mà là: doanh nghiệp đã có một kênh AI chính thức, được kiểm soát, để nhân viên không phải tự tìm cách khác hay chưa? Bất kỳ hướng nào dưới đây cũng tốt hơn việc không có chính sách gì.
1. Public Cloud AI qua tài khoản cá nhân hoặc gói phổ thông
Đây là cách bắt đầu nhanh nhất: đăng ký tài khoản, dùng ngay, không cần hạ tầng.
Phù hợp cho: thử nghiệm, viết nội dung marketing, tra cứu kiến thức chung, những việc không dính tới dữ liệu khách hàng hay dữ liệu nội bộ.
Điểm cần lưu ý:
- Tuỳ gói và tuỳ cài đặt, hội thoại trên các gói cá nhân có thể được nhà cung cấp dùng để cải thiện mô hình. Người dùng có thể tắt, nhưng doanh nghiệp khó kiểm soát việc từng nhân viên đã tắt hay chưa.
- Không có nhật ký tập trung. Khi có sự cố, doanh nghiệp không biết ai đã gửi gì, gửi lúc nào.
- Không quản lý được việc nhân viên nghỉ việc mà vẫn còn lịch sử hội thoại chứa dữ liệu công ty trong tài khoản riêng.
2. Cloud AI cấp doanh nghiệp: API, gói Enterprise hoặc chạy trong VPC
Đây là hướng hay bị gộp nhầm với lựa chọn số 1, trong khi về mặt bảo mật hai hướng khác nhau khá nhiều.
Các nền tảng như OpenAI API, Anthropic API, Azure OpenAI, AWS Bedrock hay Google Vertex AI đều có điều khoản dành cho doanh nghiệp, trong đó dữ liệu gửi qua API mặc định không được dùng để huấn luyện mô hình. Với Bedrock hay Azure OpenAI, mô hình còn có thể được gọi từ bên trong hạ tầng cloud của chính doanh nghiệp (VPC), qua kết nối riêng, chọn được vùng lưu trữ dữ liệu và ghi log theo chính sách nội bộ.
Ưu điểm:
- Dùng được những mô hình mạnh nhất hiện nay mà không phải đầu tư GPU.
- Triển khai nhanh, chi phí ban đầu thấp, mở rộng theo nhu cầu.
- Có sẵn quản lý quyền truy cập, nhật ký, mã hoá, và tích hợp với hệ thống định danh của doanh nghiệp.
Hạn chế:
- Dữ liệu vẫn được xử lý trên hạ tầng của nhà cung cấp cloud. Với một số ngành hoặc một số hợp đồng, điều này không được phép, dù có cam kết đến đâu.
- Chi phí tính theo token. Với ứng dụng đọc hàng nghìn tài liệu mỗi ngày, hoá đơn có thể tăng nhanh nếu không thiết kế tối ưu từ đầu (cache, chọn mô hình nhỏ cho tác vụ đơn giản, giới hạn độ dài ngữ cảnh).
- Cần kiểm tra các yêu cầu về chuyển dữ liệu cá nhân ra nước ngoài theo pháp luật Việt Nam (xem phần cuối).
Với phần lớn doanh nghiệp vừa và lớn, đây là điểm khởi đầu hợp lý nhất: đủ an toàn cho đa số dữ liệu nội bộ, và không phải đánh đổi chất lượng.
3. Local AI: tự vận hành mô hình trên hạ tầng riêng
Doanh nghiệp tải về một mô hình open-weight (như Llama, Qwen, Gemma, Mistral) và chạy trên máy chủ GPU tại văn phòng, trung tâm dữ liệu riêng hoặc máy chủ thuê riêng.
Ưu điểm:
- Dữ liệu không rời khỏi hạ tầng do doanh nghiệp kiểm soát. Đây thường là yêu cầu bắt buộc với dữ liệu y tế, một số dữ liệu tài chính, dữ liệu sản xuất nhạy cảm hoặc mã nguồn thuộc hợp đồng bảo mật nghiêm ngặt.
- Không phụ thuộc vào chính sách hay giá của nhà cung cấp bên ngoài.
- Có thể vận hành trong môi trường không kết nối Internet (air-gapped).
Hạn chế, và những điều thường bị nói quá:
- "Bảo mật tuyệt đối" là không có. Dữ liệu nằm trong mạng nội bộ vẫn cần phân quyền, mã hoá, ghi log và kiểm soát truy cập. Một hệ thống RAG nội bộ không phân quyền tốt có thể để nhân viên phòng kinh doanh hỏi ra được bảng lương.
- Chi phí sau đầu tư không bằng 0. Ngoài máy chủ GPU, còn có điện, làm mát, khấu hao (GPU thường lỗi thời sau 3 đến 4 năm), và quan trọng nhất là người vận hành: cập nhật mô hình, theo dõi hiệu năng, xử lý sự cố.
- Chất lượng có khoảng cách. Mô hình open-weight đã tiến bộ rất nhanh và làm tốt nhiều việc cụ thể như tóm tắt, phân loại, trích xuất thông tin, trả lời theo tài liệu nội bộ. Nhưng với suy luận nhiều bước, viết code phức tạp hay phân tích dài, mô hình chạy được trên một vài GPU vẫn thường kém các mô hình thương mại hàng đầu.
Local AI là lựa chọn đúng khi yêu cầu dữ liệu bắt buộc như vậy, hoặc khi khối lượng xử lý đủ lớn và đều đặn để chi phí phần cứng có lợi hơn trả theo token.
4. Hybrid AI: phân luồng theo mức độ nhạy cảm của dữ liệu
Hybrid không phải là một sản phẩm, mà là một cách thiết kế: mỗi yêu cầu được xử lý ở nơi phù hợp với loại dữ liệu nó chứa.
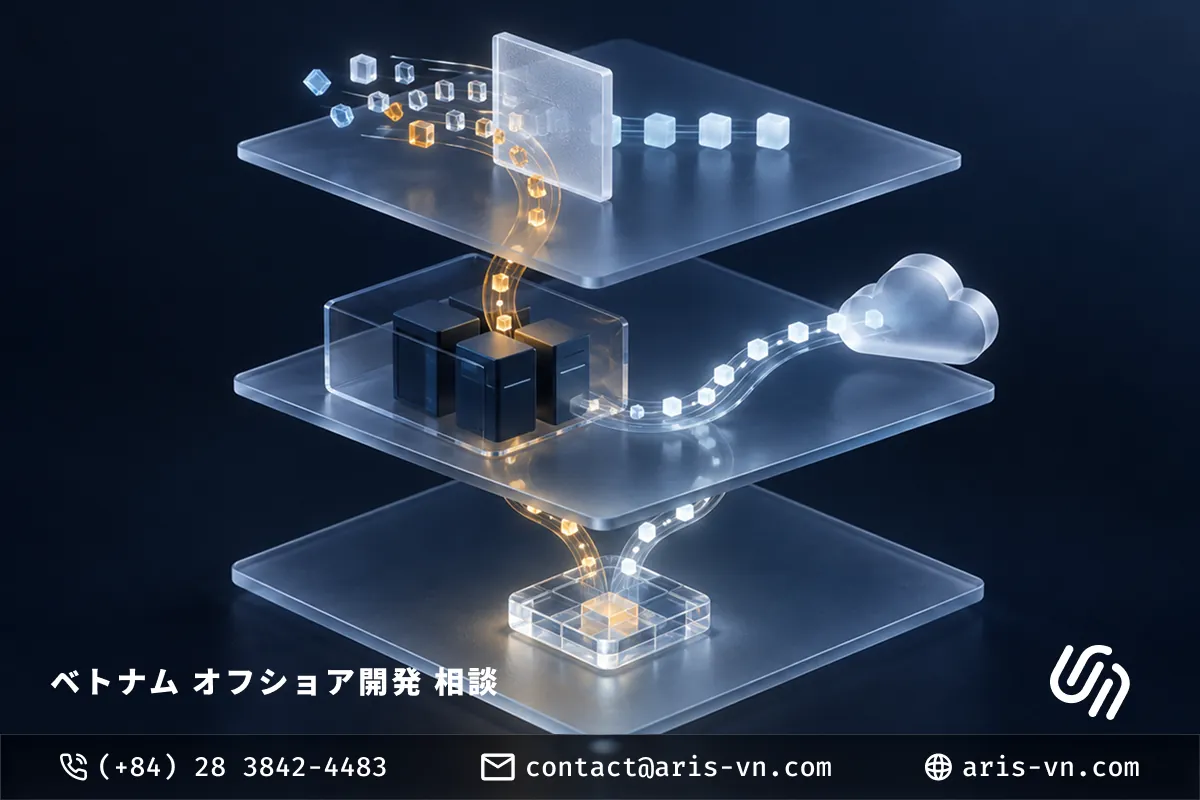
Một kiến trúc hybrid thường có ba lớp:
- Lớp phân loại và che dữ liệu, chạy nội bộ. Một mô hình nhỏ hoặc bộ quy tắc phát hiện thông tin nhạy cảm như tên khách hàng, số điện thoại, số tài khoản, số tiền, rồi thay bằng ký hiệu tạm thời. Có các công cụ mã nguồn mở hỗ trợ việc này, ví dụ Microsoft Presidio.
- Lớp định tuyến. Yêu cầu chứa dữ liệu thuộc nhóm "không được ra ngoài" được xử lý hoàn toàn bằng mô hình local. Yêu cầu đã được che, hoặc không chứa dữ liệu nhạy cảm, có thể chuyển sang mô hình cloud để tận dụng chất lượng cao hơn.
- Lớp ghép kết quả. Kết quả từ cloud được thay lại các giá trị thật ngay trong hạ tầng nội bộ trước khi trả cho người dùng.
Ưu điểm: tận dụng được chất lượng của mô hình cloud cho phần lớn công việc, trong khi dữ liệu nhạy cảm nhất vẫn ở trong nội bộ. Chi phí GPU nội bộ cũng nhỏ hơn nhiều so với chạy toàn bộ bằng local, vì mô hình nội bộ chỉ cần làm các việc nhẹ.
Hạn chế cần biết trước:
- Việc che dữ liệu không bao giờ chính xác 100%. Tên riêng viết sai chính tả, mã nội bộ không theo định dạng, hay thông tin nằm trong ảnh scan đều có thể lọt qua. Vì vậy, dữ liệu thuộc nhóm nhạy cảm nhất nên được định tuyến hẳn sang local, không chỉ dựa vào việc che.
- Khi bị che nhiều, mô hình cloud mất bớt ngữ cảnh và câu trả lời có thể kém đi.
- Hệ thống phức tạp hơn: nhiều thành phần hơn để vận hành, giám sát và kiểm thử.
Bảng so sánh nhanh
| Tiêu chí | Gói cá nhân / phổ thông | Cloud doanh nghiệp (API, VPC) ★ | Local AI | Hybrid AI |
|---|---|---|---|---|
| Dữ liệu được xử lý ở đâu | Hạ tầng nhà cung cấp, khó kiểm soát | Hạ tầng nhà cung cấp, có cam kết hợp đồng, chọn được vùng | Hoàn toàn trong hạ tầng doanh nghiệp | Nhạy cảm ở nội bộ, phần còn lại ở cloud |
| Chất lượng mô hình | Cao nhất | Cao nhất | Tốt cho tác vụ cụ thể, kém hơn ở suy luận phức tạp | Gần với cloud cho phần lớn tác vụ |
| Chi phí ban đầu | Gần như không | Thấp | Cao (GPU, triển khai) | Trung bình |
| Chi phí vận hành | Theo số tài khoản | Theo token, tăng theo khối lượng | Điện, khấu hao, nhân sự | Cả hai, nhưng phần mỗi bên nhỏ hơn |
| Thời gian triển khai | Vài ngày | Vài tuần | Vài tháng | Vài tháng |
| Năng lực vận hành cần có | Thấp | Trung bình | Cao | Cao |
| Phù hợp nhất | Thử nghiệm, việc không dính dữ liệu nội bộ | Phần lớn ứng dụng nội bộ và sản phẩm | Dữ liệu bắt buộc không được ra ngoài, khối lượng lớn và đều | Doanh nghiệp có cả hai loại dữ liệu trong cùng quy trình |
Chọn thế nào: ba câu hỏi nên trả lời trước
Câu hỏi 1: Dữ liệu sẽ đưa vào AI thuộc loại nào?
Hãy chia dữ liệu thành ba nhóm, dù chỉ trên một trang giấy:
- Công khai hoặc ít nhạy cảm: tài liệu marketing, kiến thức chung, nội dung đã công bố. Dùng cloud nào cũng được.
- Nội bộ: quy trình, báo cáo vận hành, email công việc, phần lớn mã nguồn. Cloud doanh nghiệp có hợp đồng phù hợp thường đáp ứng được.
- Hạn chế: dữ liệu cá nhân nhạy cảm, hồ sơ y tế, dữ liệu tài chính khách hàng, mã nguồn hoặc tài liệu thuộc hợp đồng cấm đưa ra ngoài. Nhóm này quyết định doanh nghiệp có cần local hoặc hybrid hay không.
Nếu không có dữ liệu thuộc nhóm thứ ba, phần lớn trường hợp không cần đầu tư local.
Câu hỏi 2: Khối lượng sử dụng là bao nhiêu, và có đều đặn không?
Tự vận hành GPU chỉ có lợi về chi phí khi máy được dùng nhiều và liên tục. Cách ước tính đơn giản:
- Chi phí cloud mỗi tháng ≈ số yêu cầu mỗi tháng × số token trung bình mỗi yêu cầu × đơn giá token của mô hình định dùng.
- Chi phí local mỗi tháng ≈ (giá phần cứng ÷ số tháng khấu hao) + điện và làm mát + phần thời gian của người vận hành.
Nếu hệ thống chỉ được dùng nhiều vào giờ hành chính, hoặc khối lượng còn đang dao động, cloud thường rẻ hơn. Khi khối lượng đã ổn định ở mức cao, phép tính bắt đầu nghiêng về local. Nên tính bằng số liệu sử dụng thật trong vài tháng thử nghiệm, không nên tính bằng dự đoán.
Câu hỏi 3: Doanh nghiệp có người vận hành không?
Local và hybrid đòi hỏi người hiểu về hạ tầng GPU, triển khai mô hình, giám sát và bảo mật. Nếu chưa có đội này, có hai lựa chọn: bắt đầu bằng cloud doanh nghiệp rồi chuyển dần, hoặc thuê một đối tác vận hành cùng.
Một lộ trình thường gặp và ít rủi ro: bắt đầu bằng cloud doanh nghiệp cho dữ liệu công khai và nội bộ, đo khối lượng thật, rồi mới quyết định có cần thêm thành phần local cho nhóm dữ liệu hạn chế hay không.
Đừng quên khung pháp lý
Tại Việt Nam, Luật Bảo vệ dữ liệu cá nhân có hiệu lực từ ngày 01/01/2026, tiếp nối Nghị định 13/2023/NĐ-CP. Khi hệ thống AI xử lý dữ liệu cá nhân, đặc biệt là khi gửi dữ liệu tới máy chủ đặt ở nước ngoài, doanh nghiệp cần xem xét các nghĩa vụ như đánh giá tác động xử lý dữ liệu và chuyển dữ liệu cá nhân ra nước ngoài.
Với doanh nghiệp làm việc cùng đối tác Nhật Bản hoặc châu Âu, hợp đồng thường có thêm điều khoản về nơi lưu trữ và xử lý dữ liệu, tuỳ theo luật APPI của Nhật hay GDPR của châu Âu. Những điều khoản này đôi khi là yếu tố quyết định kiến trúc, quan trọng hơn cả chi phí.
Bài viết này không thay cho tư vấn pháp lý. Nhưng nên đưa bộ phận pháp chế vào cuộc ngay từ giai đoạn thiết kế, thay vì đợi đến lúc hệ thống đã chạy.
ARIS Vietnam có thể hỗ trợ ở đâu
ARIS Vietnam đã có hơn 15 năm phát triển phần mềm cho khách hàng Nhật Bản và khu vực, nhiều dự án trong số đó có yêu cầu bảo mật nghiêm ngặt. Với các dự án AI, chúng tôi thường tham gia ở ba điểm:
- Đánh giá và chọn kiến trúc: cùng doanh nghiệp phân loại dữ liệu, ước tính khối lượng và chi phí, rồi chọn hướng phù hợp thay vì mặc định một giải pháp.
- Triển khai PoC có đo lường: xây phiên bản thử nghiệm trên dữ liệu thật trong vài tuần để có số liệu về chất lượng và chi phí trước khi đầu tư lớn. Xem thêm về phát triển AI và tích hợp bảo mật và tự động hoá bằng AI.
- Tích hợp vào hệ thống đang có: kết nối AI với ERP như Odoo, CRM hay hệ thống nội bộ, và triển khai trên hạ tầng AWS hoặc hạ tầng riêng của khách hàng.
Không có một kiến trúc AI phù hợp cho mọi doanh nghiệp. Nếu bạn đang cân nhắc giữa các hướng trên, hãy liên hệ với ARIS Vietnam để trao đổi về dữ liệu và bài toán cụ thể của doanh nghiệp mình.
